Phân loại Nguy cơ URL Đa lớp
Hệ thống nhận diện 5 lớp nhãn: An toàn (Benign), Lừa đảo (Phishing), Mã độc (Malware), Thay đổi giao diện (Defacement), Độc hại (Malicious).
0 URL
Mẫu kiểm tra:
Quản Lý và Nhập Mô Hình (.joblib)
Danh sách các mô hình máy học đã huấn luyện và công cụ nạp mô hình mới vào hệ thống.
Mô hình hiện có trong hệ thống
Nạp Mô Hình .joblib Mới
Hỗ trợ nạp trực tiếp từ đường dẫn file trên máy chủ hoặc tải lên từ máy tính.
Tập Dữ Liệu và Thống Kê Phân Phối
Thông tin tập dữ liệu tổng hợp 30,640,872 URL và hỗ trợ nạp kiểm tra tệp dữ liệu mới.
Tổng quan tập dữ liệu 30.6 triệu URL
30,640,872
Tổng số dòng URL
5
Số lớp nguy cơ
23,722,885
Tập huấn luyện (Train)
2,731,595
Tập kiểm thử (Test)
Phân bố các lớp nhãn trong dữ liệu:
Kiểm tra cấu trúc Dataset mới (.csv / .parquet)
Nhập đường dẫn file để tự động kiểm tra cột nhãn và hiển thị phân bố số liệu.
Báo Cáo Đánh Giá & Ma Trận Nhầm Lẫn
Kết quả đánh giá trên tập kiểm thử độc lập gồm 2,731,595 dòng URL.
Bảng so sánh hiệu năng 3 mô hình
| Mô hình | Đặc trưng trích xuất | Accuracy | Weighted-F1 | Macro-F1 | Dung lượng file |
|---|---|---|---|---|---|
| 1. Linear SVM | Word + char n-grams (3-5 ký tự) | 92.13% | 92.26% | 36.19% | 3.98 MB |
| 2. Logistic Regression | Word TF-IDF | 87.53% | 87.32% | 32.32% | 2.34 MB |
| 3. Logistic Regression | 11 đặc trưng cấu trúc (Lexical) | 77.08% | 80.65% | 29.73% | 1.9 KB |
1. Linear SVM (Word + Char n-grams)
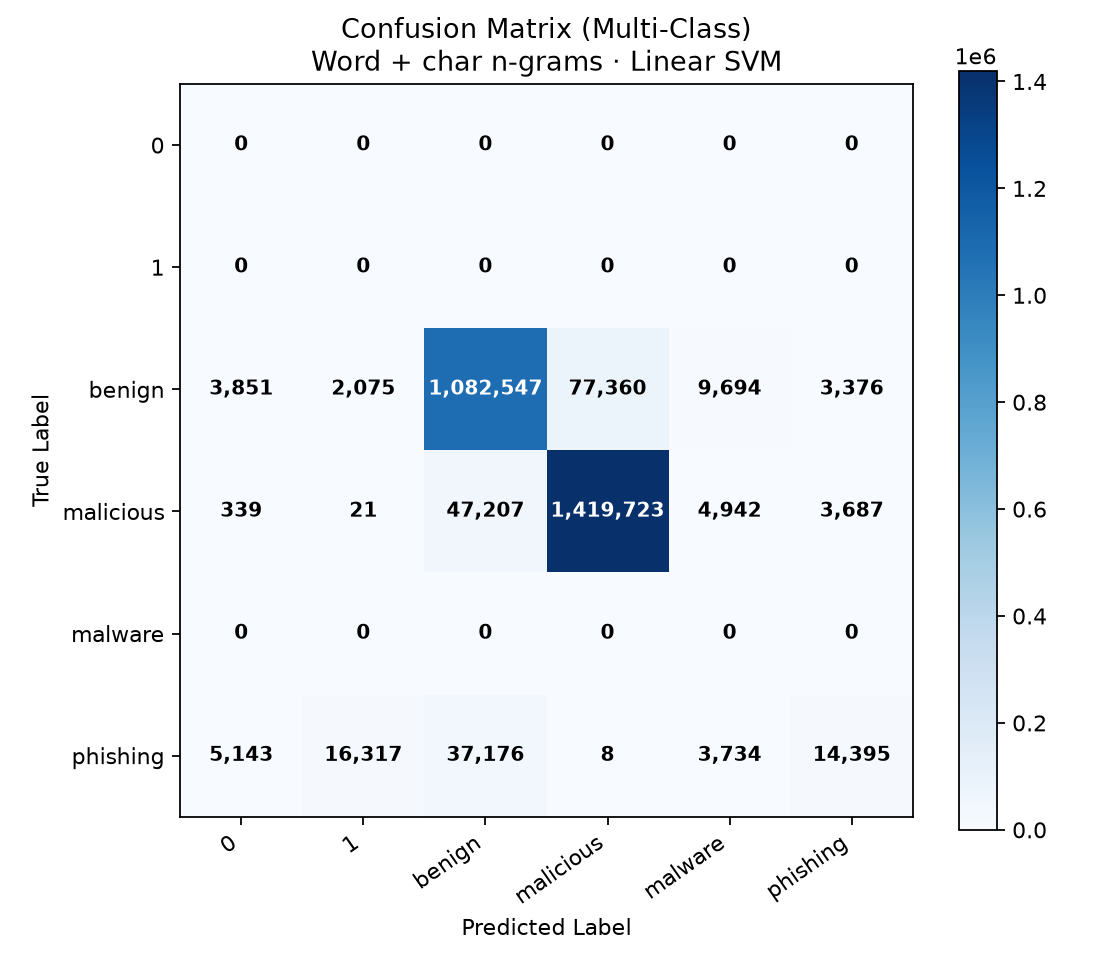
(Nhấp vào ảnh để phóng to)
2. Logistic Regression (TF-IDF)
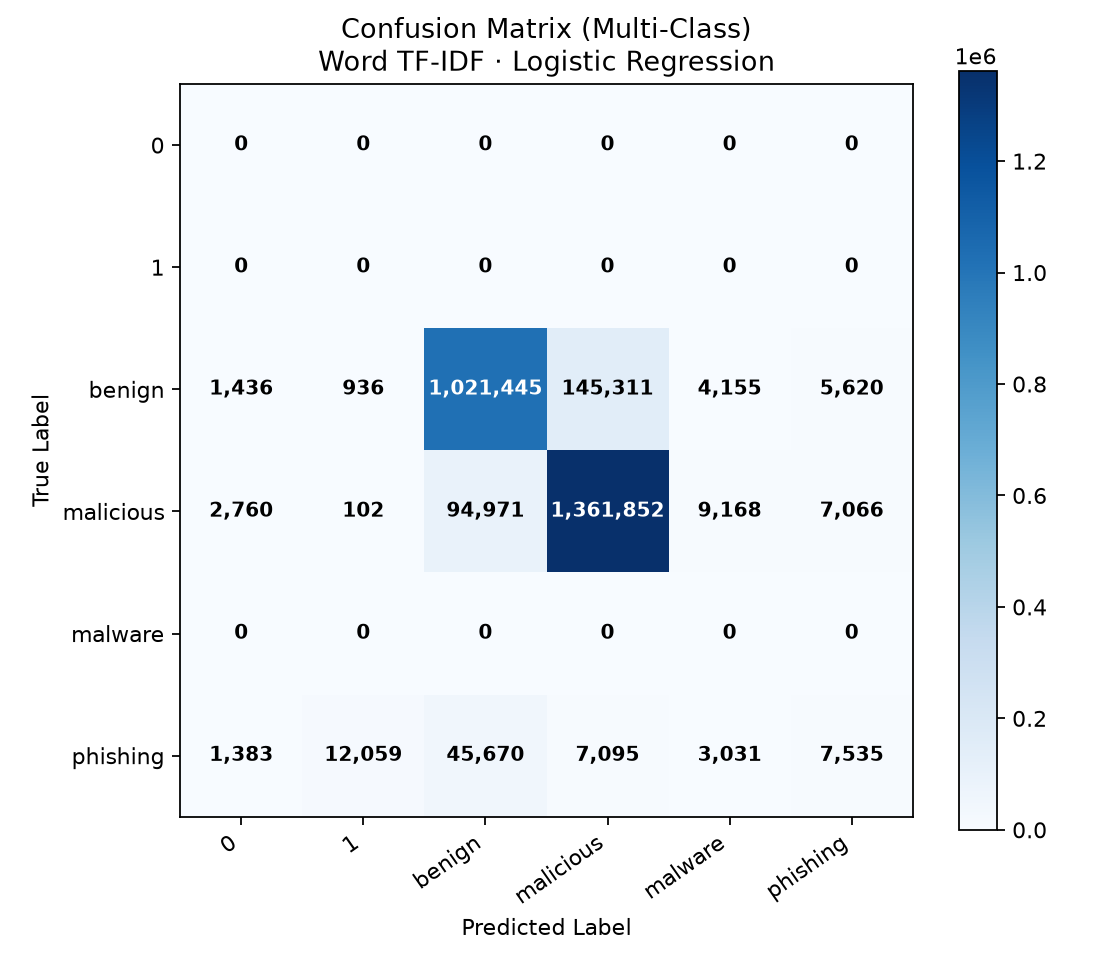
(Nhấp vào ảnh để phóng to)
3. Logistic Regression (Lexical)
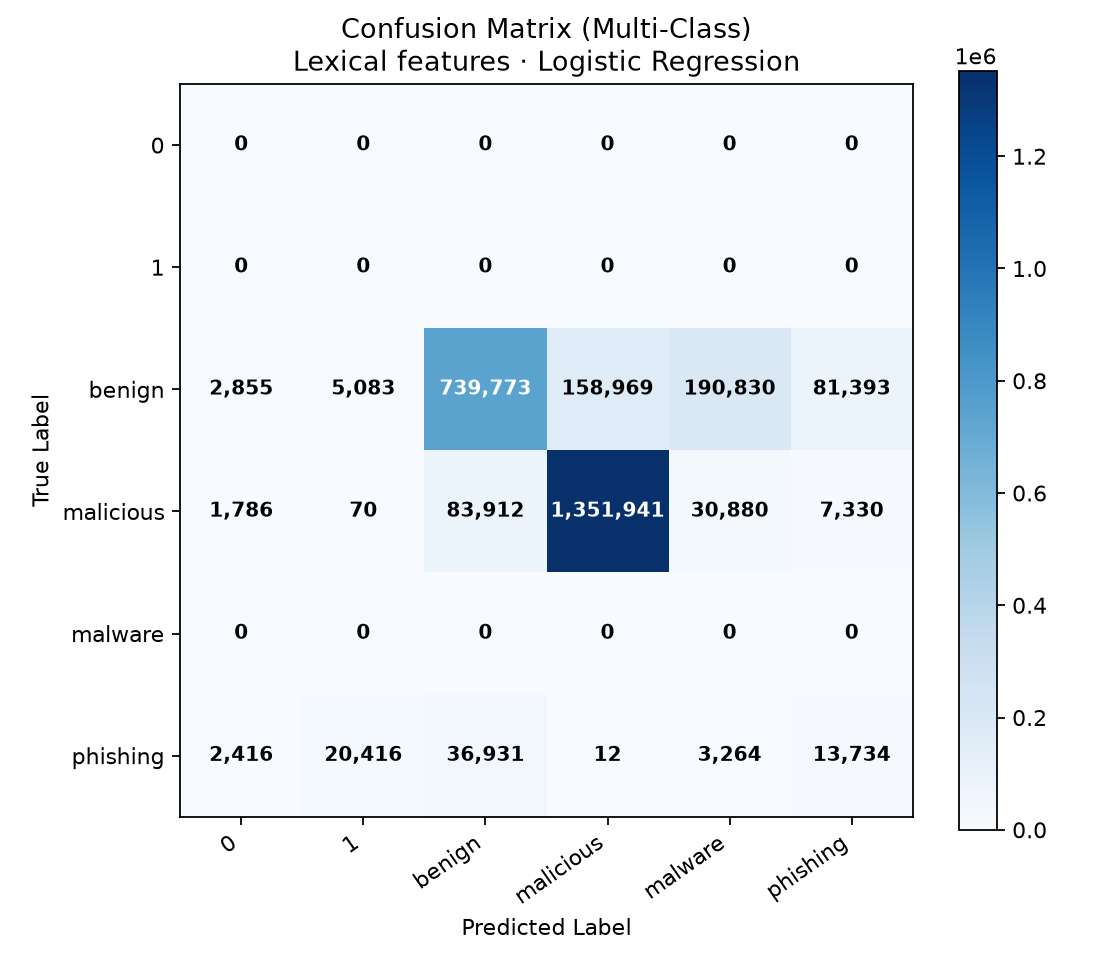
(Nhấp vào ảnh để phóng to)